数据引自官方 README(2026-10-24,v0.2.3)及第三方独立实测,
一句话: 上线一个月涨到 3.1 万 star 的 MIT 开源推理引擎,专为 Qwen3.8-Flash-Next(125B 参数 MoE 大模型)打磨:12GB 显存加 32GB 内存的普通电脑就能跑,装完在 127.0.0.1:8080 给你一个 OpenAI / Anthropic 双兼容接口,Claude Code、Codex CLI、OpenCode 直接连,聊天记录和文件不出本机。
痛点:百亿参数模型的”服务器墙”
过去两年本地 AI 的选择题一直很憋屈:7B、14B 的小模型随便跑,但能力天花板摆在那;想体验百亿参数级别的旗舰开源模型,要么交云端 API 月费,要么准备几十万的显卡服务器。125B 参数的模型,正常人看都不会多看一眼。
Strata 换了个问法:模型真的需要”装进”显存吗?
答案是不用。Qwen3.8-Flash-Next 是个 MoE(混合专家)模型:48 层、每层 512 个专家,一共 24,576 个”专家”,但每个 token 实际只激活 10 个路由专家加 1 个共享专家——真正参与计算的参数只有约 6B,占总量的 2%。剩下的 98% 参数,平时只是”待命”,不需要待在显存里。
如果你之前折腾过本地部署,对”显存墙”不会陌生(这篇生存指南把几条路线都盘过一遍)。Strata 的思路是这条路线的极端版本:不跟显存死磕,把整台电脑的存储都拉进来分工。
它怎么做到:显卡、内存、硬盘三层分工
官方 README 用了一个图书馆的比喻,很贴切:
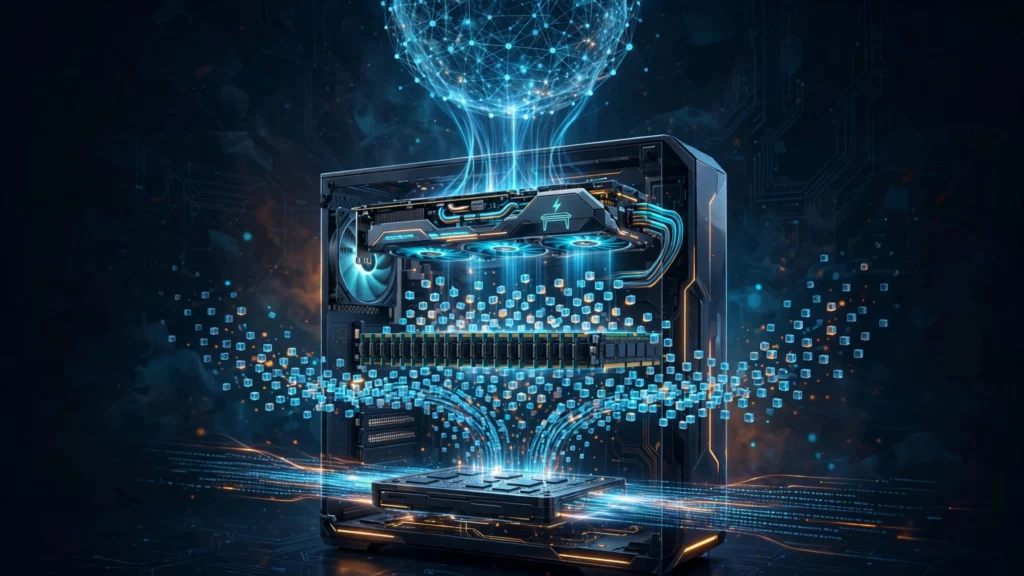
- 显卡是书桌——小而快。放每个 token 都要用的部件:注意力层、DeltaNet 混合器、路由器、共享专家、输出头、MTP 草稿层、KV 缓存的热点部分,再加一个自适应专家缓存(约 4000 个最常用的专家,显卡越大放得越多)。
- 内存是阅览室的书架——24,576 个专家全部常驻。某个 token 需要的专家不在显卡上时,CPU 直接从内存里算,和 GPU 并行,互不等待。
- SSD 是档案室——放一张 29GB 的 n-gram 查找表。模型每生成一个 token 只读其中几行,走操作系统的页面缓存就行,不用进内存。
再配两招加速:MTP(多 token 预测)让一个”小助手”先猜后面几个词,大模型一次验证,全对就白赚,快 1.6~1.8 倍;读长文档时按 8K token 大块切分并行处理,prefill 能破 1000 tok/s。
一句话总结:通用推理引擎是”把模型塞进显卡”,Strata 是”为这一个模型重写调度”,把 PC 当一台分工明确的机器用。
官方速度:先把数字摆出来
测试平台:RTX 5070(12GB)+ Ryzen 5 7600 + 64GB 内存,官方 README 数据:
| 模型尺寸 | 写答案(生成) | 读提示词(prefill) |
|---|---|---|
| Q2_0 | 94 tok/s | 2650 tok/s |
| IQ2_XS | 79 tok/s | 2090 tok/s |
| IQ3_XXS | 62 tok/s | 1750 tok/s |
| IQ3_S | 53 tok/s | 1620 tok/s |
| Coder(代码专用) | 55 tok/s | 2180 tok/s |
(1 token 约 3/4 个英文词,60 tok/s 已经比你的阅读速度快。)
显存更大的卡更快:RTX 3090(24GB)官方预估 100~140 tok/s。A 卡也不掉队:RX 9070 XT 上 Q2_0 能到 60 tok/s 生成、1160 tok/s 读提示词。
第三方验证也有:dev.to 有人拿一张 RTX 5090 给团队当代码后端实测——1 个人用 144 tok/s,4 个人同时用各 38 tok/s,8 个人各 19 tok/s。注意一个细节:多人并发时投机解码不生效,每个 token 老老实实一个一个算,所以人一多单人速度掉得比直觉快。家里自己用无所谓,给团队当”省钱后端”的话先看这个数。
先看硬件要求:内存+显存合计 32GB 起步
官方的门槛按”内存 + 显存”合计来算,64GB 内存的机器全尺寸通吃:
| 你的电脑 | 能装 |
|---|---|
| N 卡 RTX 20 / 30 / 40 / 50 系(12GB 显存以上) | 主力支持 |
| A 卡 RX 6800 及更新、Radeon AI PRO R9700(12GB 以上) | 支持,Linux 下更成熟 |
| Intel Arc 显卡 | 支持,持续加速中 |
| 苹果 Silicon Mac(M1 及更新,macOS 15+) | 支持,统一内存按合计算 |
| AMD Strix Halo(AI Max+)等统一内存机器 | 支持 |
另外需要:约 80GB 空闲硬盘(强烈建议 SSD,机械盘首次加载会很痛苦)、Windows 10/11 或 Linux 或 macOS、最新版显卡驱动。
内存决定你能跑哪个尺寸,官方给了张对照表:
| 内存+显存合计 | 选这个 | 说明 |
|---|---|---|
| 32GB | Gyro-S(27.6GB)或 Coder | Gyro 是最省内存的压缩版;Coder 砍掉一半专家,写代码专用,代码之外变弱 |
| 40GB | Swift 1.5 的 IQ2_XS(39.2GB)或 Gyro-M(35GB) | Swift 1.5 是微调版,思考时间更短,质量基本不变 |
| 48GB | IQ3_XXS(47GB) | 更慢,更准 |
| 64GB | IQ3_S(54.8GB) | 最慢,最好,和完整模型在公开测试上成绩持平 |
| 96GB 以上 | Unsloth 的 UD-IQ4_XS 到 Q8_0 | 4~8 bit,更接近完整模型 |
内存实在不够也能跑,Strata 会自动切低内存模式——只是会慢,慢很多。
上手:三条路,选一条就行
A. 装 App(最省心,推荐新手)
去 GitHub releases 页下对应你系统的安装包:Windows 选 .exe(分 N 卡新驱动 cuda13 / 老卡老驱动 cuda12 / A 卡 hip 几个版本),Linux 选 .AppImage,Mac 选 .dmg。
- Windows:双击安装,不用管理员权限。安装包还没签名,系统弹”Windows 已保护你的电脑”时点”更多信息 → 仍要运行”。
- Linux:
chmod +x后直接运行,需要 FUSE2(Ubuntu 22.04 装libfuse2,24.04 及更新装libfuse2t64)。 - Mac:拖进 Applications。
第一次打开,App 会检测你的硬件并推荐一个合适的模型尺寸,一路回车用推荐值就行。然后下载模型(40~70GB,支持断点续传),下完浏览器自动打开 http://127.0.0.1:8080,开聊。
B. 终端一行(适合服务器和脚本)
Linux / Mac:
curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh | shWindows(PowerShell):
irm https://github.com/Niko1221/Strata/releases/latest/download/install.ps1 | iex脚本会检测硬件、验 SHA-256、装到用户目录,不用管理员权限。然后:
strata launch                      # 向导:选模型、上下文长度、开不开读图
strata launch --model q2_0 --yes --no-tui   # 全自动,不问直接起服务
strata monitor                     # 实时看速度、显卡、内存占用
strata update                      # 更新引擎
strata doctor                      # 自检安装
C. 让 AI 帮你装
把这句贴给 Claude Code、Cursor、Codex 或 Copilot:
Set up Strata on this PC for me: https://github.com/Niko1221/Strata - follow docs/AI_SETUP.md in that repository.它会自己检测硬件、选尺寸、安装启动,还能通过 Strata 的 MCP server 启停服务。懒人终极形态。
装好之后:三种用法
1. 直接聊天
App 里有 Chat、Monitor(实时看模型/GPU/CPU/内存)、Models、Settings。聊天可以指定一个文件夹让它在里面工作,Manual 模式下改文件、跑命令前会先问你。输入 /loop 10m 做什么事 可以每 10 分钟重复一条指令。还能联网搜索(DuckDuckGo,不用账号)——这是唯一会离开你电脑的数据,只有搜索词。
2. 当本地 API 后端,这是精髓
| 想接的工具 | 填这个地址 |
|---|---|
| OpenAI 兼容(绝大多数 App 和 Agent) | http://127.0.0.1:8080/v1(API key 和模型名随便填) |
| Anthropic 兼容(Claude Code 等) | http://127.0.0.1:8080(Claude Code 设 ANTHROPIC_BASE_URL=http://127.0.0.1:8080) |
| OpenAI Responses(Codex CLI) | http://127.0.0.1:8080/v1/responses |
跑 strata connect 直接打印 OpenCode、Codex CLI、Claude Code 等一堆工具的配置,加 --write 还能帮你写文件(会备份原文件)。
这意味着:你之前搭的各种 Agent 都可以把后端换成这台本机模型,Docker Agent那种”接本地模型不用 API Key”的玩法,这里直接给了一个旗舰级模型当底座。局域网里想给手机或另一台电脑用?strata launch --access lan,会自动生成 API key。
3. 读图和思考档位
图片输入默认开着:聊天里直接粘贴图片就行。24GB 以下显存的卡,读图走 CPU(慢几秒,不占显存);24GB 以上走显卡。思考强度可以在聊天菜单里切 off / low / medium / high——off 最快,难题切 high。
OpenAI 兼容接口的接法,之前在局域网部署 Prompt Optimizer 接 llama.cpp那篇里验证过同一套路,换个 base URL 就能用。
常见问题
Q:第一次启动电脑卡住 1~3 分钟,是不是死了?
A:没死。Strata 在往内存里搬 35~55GB 的模型,还要锁一部分给显卡用。等着,别关窗口。10 分钟还卡再重启电脑、关掉其他程序,或换个更小的尺寸。
Q:模型下到一半断了怎么办?
A:重跑安装/启动命令,断点续传。
Q:跑起来巨慢,硬盘灯狂闪?
A:内存不够了。关掉浏览器这种内存大户(浏览器很能吃),或换 Q2_0 / IQ2_XS 这种小尺寸。
Q:提示 8080 端口被占用?
A:Strata 已经在跑了,找它的窗口就行。
Q:想测自己电脑的真实速度?
A:跑 BENCH.bat(Linux 是 ./bench.sh),5~10 分钟出一份可分享的报告。
先泼三盆冷水
- 更新快得离谱。 作者日更甚至半天一更,一个月发了 57 个 release。0.2.1 才刚宣布”这条线以后不再乱改”,之前每个版本都可能行为大变。跟进更新别嫌烦,
strata update --check先看。 - 小尺寸有代价。 压缩得越狠,代码和复杂推理掉得越多;Coder 版官方自己承认中文和 CJK 文字偏弱。要质量直接上 IQ3_S,别在 32GB 的机器上指望旗舰体验。
- 还不是生产工具。 Mac 上 Metal 后端一次只能服务一个请求(并发还没移植);A 卡在 Windows 上读图还没好(Linux 可以);70GB 的下载和首次加载的等待都是真实成本。先当折腾尝鲜,别急着把生产流量切过来。
另外分清两个授权:Strata 引擎本身是 MIT,随便用;但 Qwen3.8-Flash-Next 模型本体遵循 Qwen Community License 1.0,商用前看一眼模型授权条款。
适合谁 / 不适合谁
适合:想零成本体验旗舰级开源大模型的人;想给 Claude Code / Codex 换个本地后端、省订阅费的人;HomeLab 玩家;对推理引擎优化本身感兴趣、想看看到底怎么”榨干”硬件的极客。
不适合:内存加显存不到 32GB 的人(先加内存条);要开箱即用、拿来替代 ChatGPT 日常办公的人;指望它当生产级 API 服务扛并发的人。
是否值得试
Strata 回答的不是”本地 AI 能不能用”,而是”一台游戏电脑离数据中心还有多远”——答案是:只差一个懂分层的引擎。一个月 3.1 万 star 不是营销,是全世界有一帮人真的在拿它当主力推理用。如果你内存够大,这可能是今年本地 AI 圈最值得折腾的一次。
相关链接
- 项目地址:https://github.com/Niko1221/Strata(MIT 协议,含简体中文 README)
- 模型:Qwen 团队 Qwen3.8-Flash-Next(模型本体遵循 Qwen Community License 1.0)
- 引擎基于 llama.cpp / ggml 的部分代码,量化权重来自 ISTA-DASLab 等社区贡献者