一句话: 腾讯开源的自托管 LLM 知识库平台(MIT),3 万+ star。把文档、飞书、语雀、Notion 里的资料变成带引用的 RAG 问答库,还附带 Agent 智能推理和自动生成的 Wiki。Docker 一行命令就能跑起来。
痛点:资料越攒越多,问个问题先翻半小时
公司文档在飞书,个人笔记在 Notion,产品手册是一堆 PDF,微信群文件天天过期。想查一个配置参数,先回忆”这东西我存哪儿了”。
另一头,想搭个自己的 RAG 知识库的人也不少:LangChain 拼一套能跑,但解析、切块、向量库、重排、Web 界面全要自己攒,链条一长就没人维护了。
WeKnora 的定位就是:把这套链条做成开箱即用的产品——传文档、配模型、提问,三步完事。
它能干什么
核心是三件事,都跑在同一套知识库上:
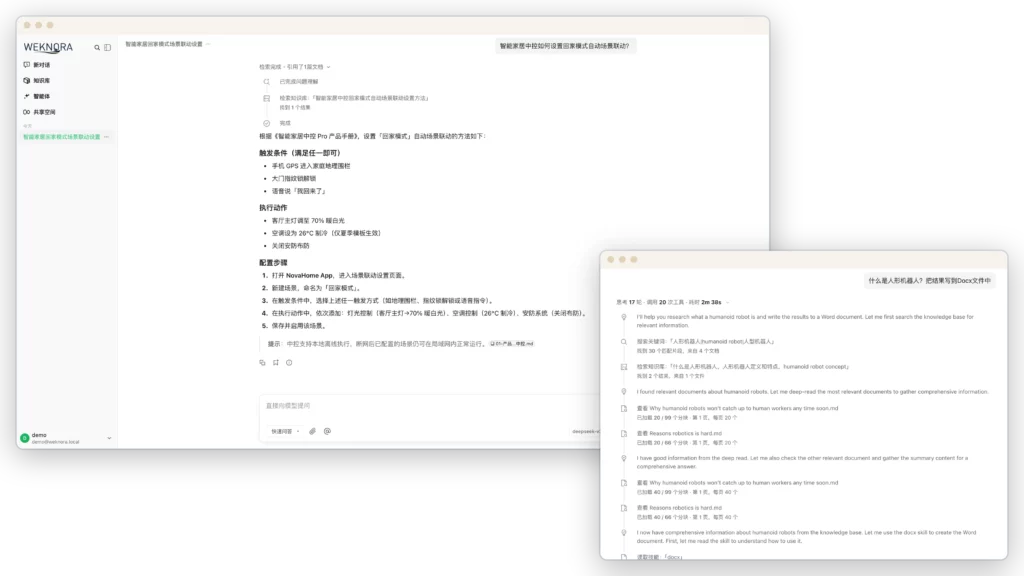
- 快速问答:检索相关片段生成回答,每个答案带原文引用,点引用直接跳到出处。
- 智能推理:ReAct Agent 模式,多步骤任务自己规划——搜库、读文档、调工具、甚至操作你电脑上的浏览器(通过 BrowserSkill 扩展),过程全展示。
- 自动 Wiki:从文档里抽取人物、产品、概念,自动生成互相链接的 Markdown Wiki 页面和知识图谱,页面可改、可回滚。
周边能力不少:飞书/飞书云盘、Confluence、GitLab、Notion、语雀、钉钉文档、RSS 自动同步;企业微信、飞书、Slack、Telegram、QQ、微信等 IM 问答通道;内置 MCP Server,给 Cursor / Claude 当知识库工具用;PDF / Word / Excel / PPT / EPUB / XMind / 图片 / 音频,十几种格式通吃。
模型支持 27 家:Ollama 本地模型、DeepSeek、Qwen、智谱、硅基流动、OpenAI 兼容 API 都行。对话模型和向量模型分开配,界面里带连通性测试按钮。
上手:标准部署四步
机器要求:Docker + Docker Compose。标准版官方建议 4 核 CPU / 8GB 内存起步(docreader 含 LibreOffice、Playwright,比较吃内存),这个数不含 Ollama 模型权重的开销。
1. 拉代码、准备环境变量
git clone https://github.com/Tencent/WeKnora.git
cd WeKnora
cp .env.example .env
.env 里几个必填项自己填:DB_USER / DB_PASSWORD / DB_NAME、REDIS_PASSWORD、JWT_SECRET、SYSTEM_AES_KEY。密钥生成:
openssl rand -hex 32   # JWT_SECRET
openssl rand -hex 16 # SYSTEM_AES_KEY(32 字节)注意:SYSTEM_AES_KEY 升级时必须沿用旧的,否则已加密的凭据解不出来。
2. 启动
make start-all     # 一键封装:拉镜像、兜底 .env、检查 Ollama
# 或原生命令:
docker compose pull && docker compose up -d
3. 注册登录
浏览器打开 http://localhost,首次访问是注册页(系统没有默认账号)。注册后自动建个人工作空间,你就是 Owner。
4. 建库、配模型、传文档、提问
在「知识库」页新建(选 document 文档库或 faq 问答对库),初始化向导会让你选对话模型和向量模型:
- 本地 Ollama:先在宿主机
ollama serve跑起来,容器里填http://host.docker.internal:11434 - 远程 API:DeepSeek / 通义 / 智谱等,填
base_url+api_key,点「测试」确认连通
然后直接拖文件或粘贴网页 URL 上传,文档异步解析(pending → processing → finalizing → completed),解析完进对话页选知识库就能问了。答案正常显示且引用能点开,说明链路跑通。
懒得折腾 Docker 的还有 Lite 单二进制:SQLite + 内存队列,零外部依赖,一个进程跑全套,适合个人本机用。桌面应用目前尚未正式发布,别等。
先看硬件要求
| 部署形态 | 配置 |
|---|---|
| Docker 标准版 | 4 核 CPU / 8GB 内存起步(不含模型权重);磁盘按知识库规模预留 |
| Lite 单二进制 | 低资源本机,SQLite + 内存队列,无外部依赖 |
| 模型 | 远程 API 最省事;本地 Ollama 跑 qwen3:8b 这类模型,另需 8GB+ 内存/显存 |
想全本地:qwen3:8b(对话)+ bge-m3(向量)是官方文档示例里的搭配,普通带显卡的台式机或 Mac 都能跑。Ollama 的安装和模型选择可以看本站这篇:本地大模型部署终极生存指南:从”手搓裸机”到”精装入驻”。
常见问题(官方 FAQ 整理)
Q:初始化时 Ollama 检测失败?
A:容器里的 localhost 指的是容器自己。宿主机 Ollama 用 http://host.docker.internal:11434。Linux 上要确认 compose 的 extra_hosts: host.docker.internal:host-gateway 生效了。
Q:文档上传后一直卡在 processing?
A:看 docker logs WeKnora-docreader。大文件受 MAX_FILE_SIZE_MB(默认 50)和解析超时(默认 2 小时)限制,PDF 扫描件会慢一些。
Q:问答没有引用 / 召回为空?
A:先确认文档解析状态是 completed;再检查 embedding 模型是不是和建库时一致(换了向量模型要重建索引);检索阈值 vector_threshold 可以调低试试。
Q:注册页签不见了?
A:查 GET /auth/config 的 registration_mode,管理员可能在「设置 → 系统」里关了公开注册。此时只能走邀请链接。
Q:Docker 自托管还有哪些坑?
A:可以参考本站这篇 Docker 实战:用 Docker 在局域网部署 Prompt Optimizer,端口映射和局域网访问的思路通用。
先泼三盆冷水
- 别公网暴露。 官方 README 明确警告:生产部署强烈建议放内网,不要直接暴露到公网。9 月中旬刚修过一个跨租户数据隔离漏洞(GHSA-2f4c-vrjq-rcgv),自托管的东西,安全是自己的责任。
- 迭代极快,升级留神。 40 个 releases,数据库是 ParadeDB(PostgreSQL 17 + 向量扩展),跨版本升级要看升级说明,直接
pull覆盖可能出问题。 - 桌面版还没发布。 README 写得很清楚:桌面应用”no installer is published yet”,想双击即用的再等等,源码编译玩家除外。
适合谁 / 不适合谁
适合:HomeLab / NAS 玩家想搭私人知识库的人;小团队想把飞书/语雀文档变成问答机器人的;折腾 RAG 但不想从 LangChain 手搓的人;想给 Cursor / Claude 接私有知识库 MCP 的人(MCP 部署思路见本站这篇:为本地大模型接入 MCP 服务)。
不适合:就想问几个 PDF、装个软件都不想的人——杀鸡用牛刀;指望开箱就有大模型的人——模型要自己接 API 或本地跑;要公网给全公司用又没运维能力的人——先看第一盆冷水。
一句话
WeKnora 回答的是”团队/个人的知识资产怎么变成能对话的东西”——不卖概念,Docker 一行命令起服务,中文文档齐全,飞书语雀 Notion 全接上。对中文折腾党来说,少见的开箱友好度。先内网跑起来,公网的事以后再说。
相关链接
- 项目地址:https://github.com/Tencent/WeKnora(README 有简体中文版)
- 中文文档:https://weknora.weixin.qq.com/docs
- 开源协议:MIT(LICENSE 原文;第三方组件按各自协议,见仓库 licenses/ 目录)
- 当前版本:v0.8.2(2026-09-24),仓库昨日(2026-09-28)仍有提交